MDM tool එකක් ගන්නේ නැතුව අවුල් records match කරමු: Splink ගැන practical guide එකක්
කවදා හරි දවසක ඕනම data team එකකට මේ ප්රශ්නෙට මූණ දෙන්න වෙනවා. ඇත්තටම එකම customer කෙනෙක්, company එකක්, patient කෙනෙක් systems තුන හතරක ඉන්නවා, ඒත් එයාව අඳුරගන්නේ කොහොමද කියන එක ගැන එක system එකක්වත් අනිත් ඒවා එක්ක එකඟ නෑ. CRM එකේ ඒක ACME Corp, id එක 1042. Billing system එකේ Acme Corporation Ltd, id එක BX-77. කවුරුහරි ගිය අවුරුද්දේ import කරපු spreadsheet එකක acme corp. කියලා තියෙනවා, විශ්වාස කරන්න පුළුවන් id එකක් නම් නෑ. ඔයාට ඕන එක master record එකක්, ඒ වගේම හැම transaction එකක්ම ආපහු ඒ record එකට සම්බන්ධ කරන්න ක්රමයක්.
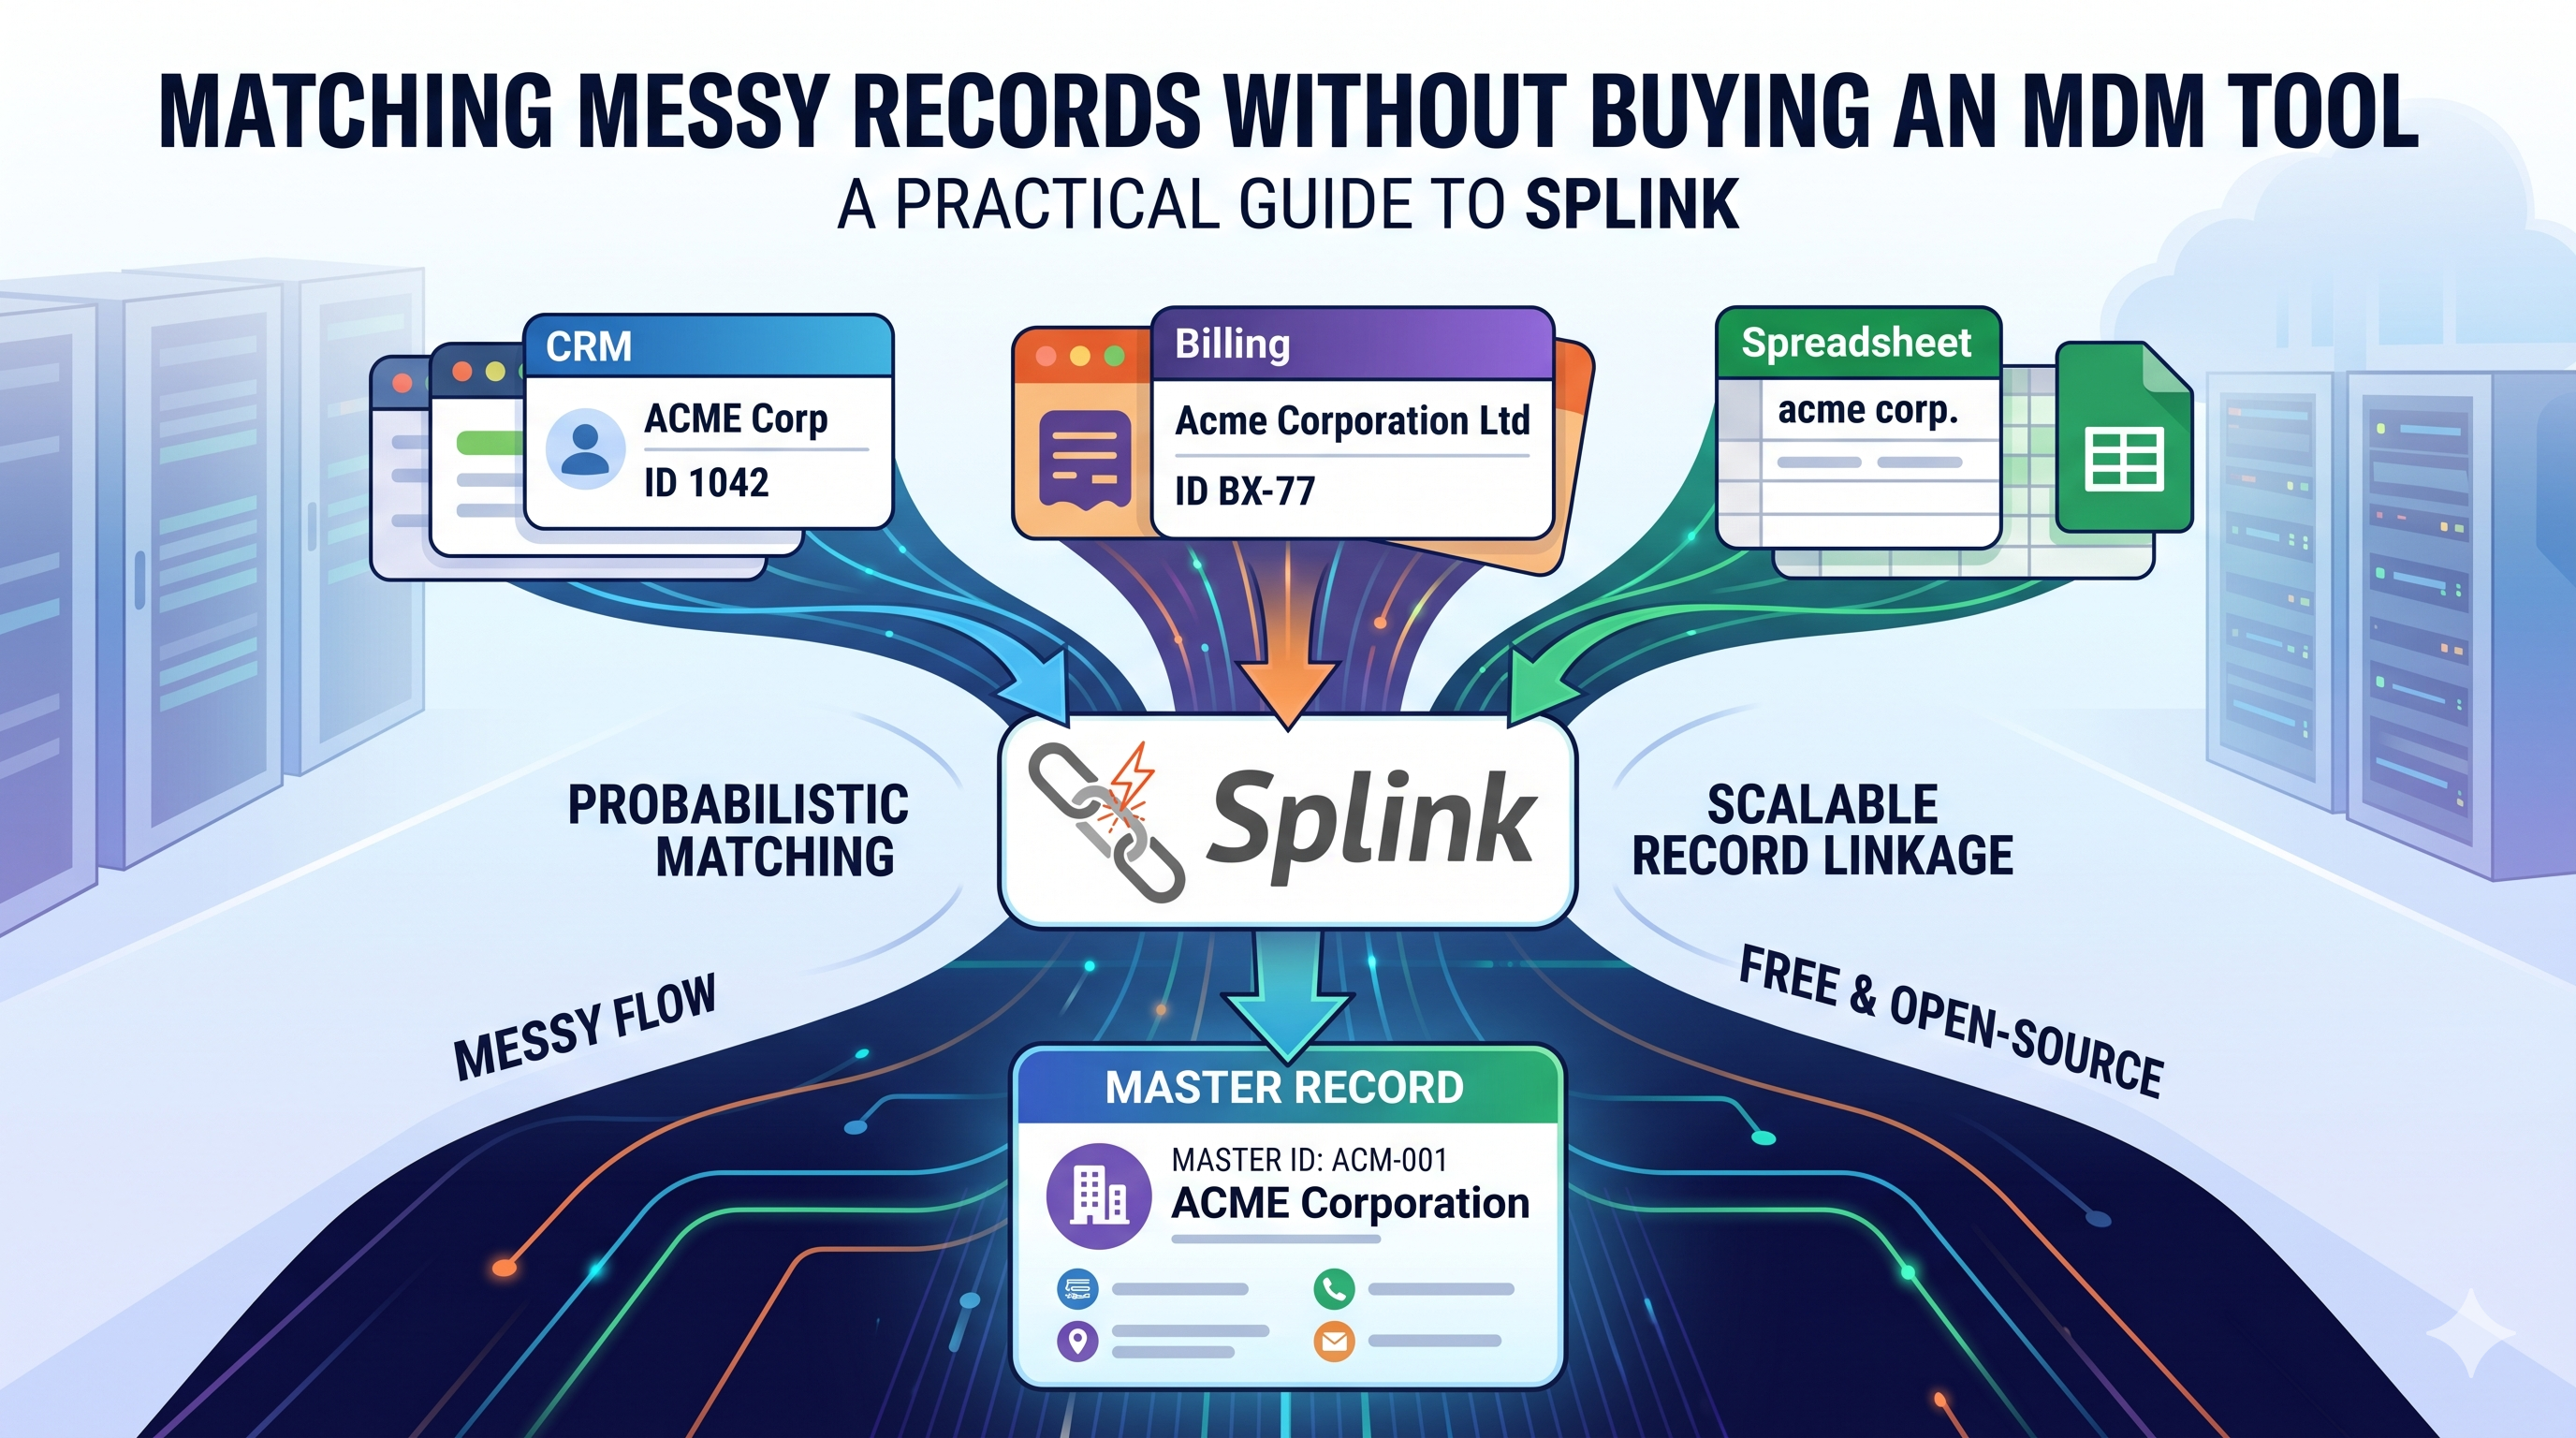
කවදා හරි දවසක ඕනම data team එකකට මේ ප්රශ්නෙට මූණ දෙන්න වෙනවා. ඇත්තටම එකම දෙයක් — customer කෙනෙක්, company එකක්, patient කෙනෙක් — systems තුන හතරක ඉන්නවා, ඒත් ඒක අඳුරගන්නේ කොහොමද කියන එක ගැන එක system එකක්වත් අනිත් ඒවා එක්ක එකඟ නෑ. CRM එකේ ඒක ACME Corp, id එක 1042. Billing system එකේ Acme Corporation Ltd, id එක BX-77. කවුරුහරි ගිය අවුරුද්දේ import කරපු spreadsheet එකක acme corp. කියලා තියෙනවා, විශ්වාස කරන්න පුළුවන් id එකක් නම් නෑ. ඔයාට ඕන එක master record එකක්, ඒ වගේම හැම transaction එකක්ම ආපහු ඒ record එකට සම්බන්ධ කරන්න ක්රමයක්.
පොතේ තියෙන උත්තරේ තමයි "master data management platform එකක් ගන්න" කියන එක. ඒක වැඩ කරනවා තමයි. ඒත් ඒ tools ගොඩක් ගණන්, roll out කරන්නත් ගොඩක් කල් යනවා. ඇත්තම කිව්වොත්, ඔයාගේ ඇත්ත ප්රශ්නේ "මට rows මිලියන කීපයක් තියෙනවා, ඒවා match කරන job එක කොහොමටවත් හරියන්නේ නෑ" කියන එක නම්, ඒ tools ඕනවට වඩා වැඩියි. මම ආයේ ආයේ ආපහු එන විකල්පය ගැන තමයි මේ ලිපිය: Splink. ඒක free, open-source library එකක්. අමාරුම කොටස — මොන records ද ඇත්තටම එකම දේ කියලා තීරණය කරන එක — Splink පුදුම විදිහට හොඳට කරනවා. ඒකත් ගොඩක් paid tools මහා ගණන් අය කරන scale එකකින්.
Splink කියන්නේ මොකක්ද, ඒක ඇත්තටම වැඩ කරන්නේ කොහොමද (marketing කතාව නෙවෙයි), ඔයාගේ වැඩේට ගලපගන්න පුළුවන් සම්පූර්ණ example එකක්, ඒ වගේම documentation එකේ උඩින් පල්ලෙන් යන practical පාඩම් ටිකක් — මේ ඔක්කොම ගැන මම මෙතන කතා කරනවා.
සාමාන්ය SQL join එකක් මෙතනදී වැඩ නොකරන්නේ ඇයි
මුලින්ම හිතෙන්නේ JOIN ON company_name කියලා ලියන්න. ඒක එතනම fail වෙනවා, මොකද ACME Corp යි Acme Corporation Ltd යි එකම string නෙවෙයි. එතකොට ඔයා fuzzy logic පැත්තට හැරෙනවා — සමහර විට LIKE එකක්, නැත්නම් අතින් තෝරගත්ත cutoff එකක් එක්ක Levenshtein distance එකක්. ඒකෙන් පොඩ්ඩක් ඉස්සරහට යන්න පුළුවන්, ඒත් ටික කාලෙකින් ඒක තමන්ගේම බරට කඩාගෙන වැටෙනවා. ඒකට හේතු දෙකක් තියෙනවා.
පළවෙනි එක, එක column එකක් උඩ හදන එක similarity score එකකින් information ගොඩක් නැති වෙනවා. නම සමාන වුණාට city එකයි tax number එකයි වෙනස් company දෙකක් බොහෝ විට එකම company එක නෙවෙයි. නම පොඩ්ඩක් වෙනස් වුණාට registration number එක හරියටම එකයි නම්, ඒ දෙක එකම company එක වෙන්නම ඉඩ තියෙනවා. නම් අතර distance එක විතරක් බලන සරල rule එකකට මේ signals එකිනෙකට සාපේක්ෂව කිරලා බලන්න බෑ.
දෙවෙනි එක, compare කරන්න ඕන ගණන පුපුරලා යනවා. හැම record එකක්ම අනිත් හැම record එකක් එක්කම compare කරනවා කියන්නේ n² ප්රශ්නයක්. Records මිලියනයක් තියෙනවා නම් comparisons බිලියන 500 ක් විතර. කොච්චර දක්ෂ WHERE clause එකක් ලිව්වත්, ඒකෙන් විතරක් මේකෙන් ගොඩ එන්න බෑ.
Splink මේ ප්රශ්න දෙකම විසඳන්නේ statistical model එකකුයි blocking කියන technique එකකුයි පාවිච්චි කරලා. ගැඹුරට යන්න කලින්, මුළු pipeline එකම එක පාරක් බලමු.
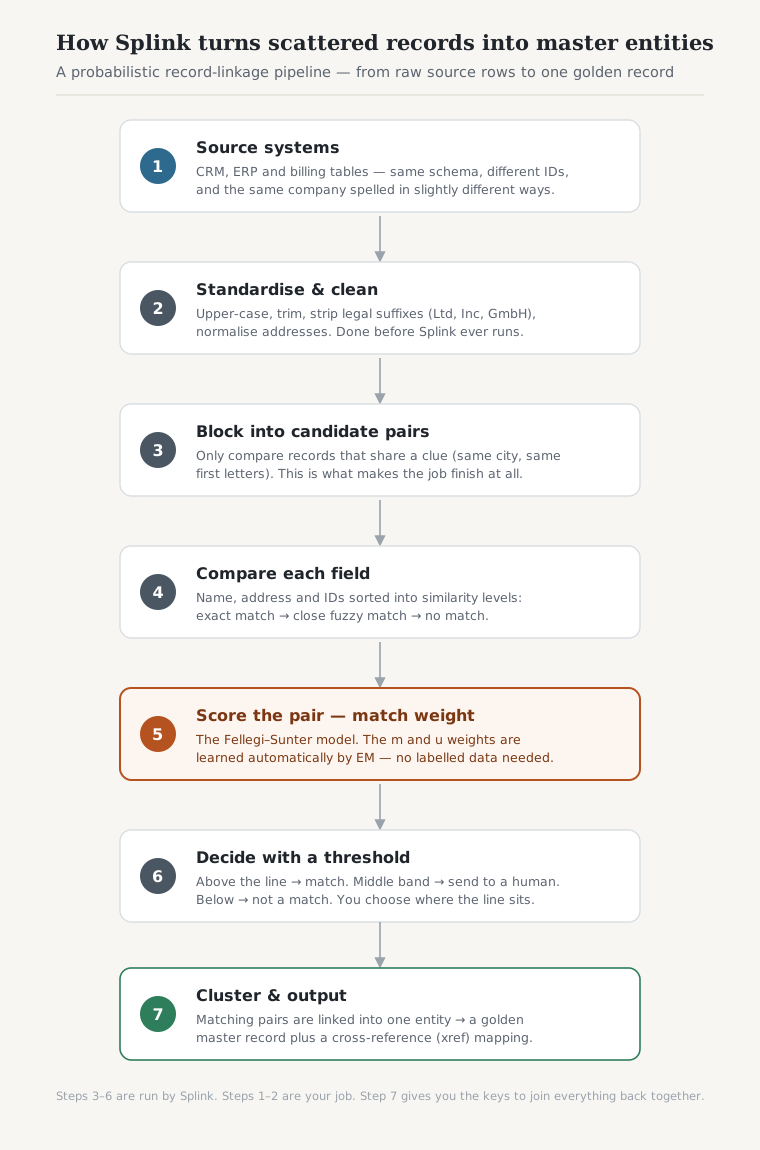
Splink pipeline එක. පියවර 3–6 library එක ඔයා වෙනුවෙන් run කරනවා; පියවර 1–2 ඔයාම කරගන්න ඕන සූදානම; පියවර 7 න් ඔක්කොම ආපහු එකට අමුණන්න ඕන keys ඔයාගේ අතට දෙනවා.
ඇත්තටම Splink කියන්නේ මොකක්ද
Splink හැදුවේ UK Ministry of Justice එකේ data scientists ලා. පොදු identifier එකක් නැති ලොකු administrative datasets — court records, prison records වගේ දේවල් — link කරන්න තමයි ඒක හැදුවේ. සරලව කිව්වොත්, මේක probabilistic record linkage (entity resolution) සඳහා තියෙන Python package එකක්. Unique identifiers නැති datasets වල records deduplicate කරන්නත්, එකිනෙකට link කරන්නත් මේකෙන් පුළුවන්. Download ගණන මිලියන කීපයක් පහු කරලා තියෙනවා, NHS England, UK එකේ Office for National Statistics වගේ ආයතන මේක production වල පාවිච්චි කරනවා.
Company-master ප්රශ්නෙට මේක හොඳටම ගැලපෙන්න හේතු තුනක් තියෙනවා.
පළවෙනි එක, ඔයා දැනටමත් පාවිච්චි කරන engine එක උඩම මේක run වෙනවා. එක machine එකක DuckDB එක්ක Python වලින් linkage run කරන්න පුළුවන්. Rows මිලියන 100 ට වැඩි datasets නම් Spark වගේ big-data backends පාවිච්චි කරන්න පුළුවන්. ඔයා වැඩ කරන්නේ Microsoft Fabric, Databricks, නැත්නම් වෙන ඕනම Spark-based platform එකක නම්, ඔයා දැනටමත් සල්ලි ගෙවන session එකටම Splink කෙලින්ම plug වෙනවා.
දෙවෙනි එක, මේක ඇත්තටම වේගවත්. Laptop එකක records මිලියනයක් විනාඩියක් විතර ඇතුළත link කරන්න පුළුවන්. ඒක typo එකක් නෙවෙයි. ඒකෙන් ඔයා වැඩ කරන විදිහම වෙනස් වෙනවා — රෑ තිස්සේ run වෙන batch එකක් ඉවර වෙනකන් බලන් ඉන්නේ නැතුව, තත්පර ගාණකින් model එක වෙනස් කර කර බලන්න පුළුවන්.
තුන්වෙනි එක, මේකට training data ඕන නෑ. Model training එක unsupervised, ඒ නිසා පටන් ගන්න කලින් දන්න matches වල labelled set එකක් හදාගන්න ඕන නෑ. ගොඩක් අයට විශ්වාස කරන්න අමාරු කොටස මේක. ඉතින් Splink ඒක කරන්නේ කොහොමද කියලා මම පැහැදිලි කරන්නම්.
ඇතුළේ වෙන්නේ මොකක්ද: වට කරකවන්නේ නැතුව කෙලින්ම
Splink හදලා තියෙන්නේ Fellegi–Sunter model එක උඩ. 1969 දී ආපු statistics කෑල්ලක් වුණාට, අදටත් serious record linkage වල කොඳු නාරටිය ඒක. නම ඇහුවම හිතෙන තරම් අමාරු නෑ අදහස.
ඕනම records දෙකක් අරන් field එකෙන් field එක බලන්න. හැම field එකක් ගැනම ප්රශ්න දෙකක් අහන්න:
- මේ records දෙක ඇත්තටම එකම company එක නම්, මේ field එක එකඟ වෙන්න තියෙන ඉඩ කොච්චරද? ඒකට අපි m probability කියමු. Tax number වගේ field එකක m ගොඩක් වැඩියි — ඇත්ත matches වලට හැමවෙලේම වගේ එකම tax number එක තියෙනවා.
- මේ records දෙක එකම company එක නෙවෙයි නම්, නිකම්ම අහම්බෙන් මේ field එක එකඟ වෙන්න තියෙන ඉඩ කොච්චරද? ඒකට u probability කියමු. Tax number එකේ u ඉතාම පොඩියි — එකිනෙකට කිසිම සම්බන්ධයක් නැති company දෙකකට එකම tax number එක තියෙන එක වගේ වෙන්නේම නෑ. ඒත් "country = United States" වගේ field එකක u ලොකුයි, මොකද එකිනෙකට සම්බන්ධ නැති company ගොඩක් American.
ඔය අගයන් දෙකේ ratio එක තමයි ඒ field එකෙන් ලැබෙන සාක්ෂිය. Splink ඒක log2 scale එකේ තියෙන match weight එකකට හරවනවා. එතකොට හැම field එකකින්ම එන weights සරලව එකතු කරන්න පුළුවන්. එකඟ වීම match එකකට ශක්තිමත් සාක්ෂියක් වෙන field එකක් (tax number වගේ — m වැඩියි, u අඩුයි) ලොකු positive weight එකක් දෙනවා. කොහොමත් හැමවෙලේම එකඟ වෙන field එකකින් (country වගේ) ලැබෙන්නේ නැති තරම් පොඩි දායකත්වයක්. Field එකක් එකඟ නොවුණොත් weight එක පහළට තල්ලු වෙනවා. ඔක්කොම fields වල weights එකතු කළාම pair එකට එක score එකක් ලැබෙනවා: ලොකු positive අගයක් නම් "අනිවාර්යයෙන්ම වගේ එකම එක", ලොකු negative අගයක් නම් "අනිවාර්යයෙන්ම වගේ වෙනස්".
මෙතන තියෙන දක්ෂ කොටස තමයි, Splink m සහ u අගයන් ඔයාගේ data වලින්ම automatically ඉගෙනගන්න එක. ඒකට පාවිච්චි කරන්නේ Expectation–Maximisation (EM) කියන algorithm එක. මුලින් දළ අනුමානයකින් පටන් අරන් pairs වලට score කරනවා. ඊට පස්සේ ඒ scores පාවිච්චි කරලා probabilities ආපහු ගණන් බලනවා. අගයන් වෙනස් වෙන එක නවතිනකන් මේ වැඩේ දිගටම කරනවා. Labelled examples ඕන නොවෙන්නේ මේ loop එක නිසා.
Practically වැදගත් වෙන තවත් දියුණු කිරීම් දෙකක් තියෙනවා. Comparison levels නිසා field එකක් "match ද නැද්ද" කියන දෙකට විතරක් සීමා වෙන්නේ නෑ — exact match එකක්, ගොඩක් ළඟින් යන fuzzy match එකක් (උදාහරණයක් විදිහට Jaro–Winkler similarity එක 0.9 ට වැඩි), අනිත් ඔක්කොම කියලා levels හදලා, හැම එකකටම වෙනම weight එකක් දෙන්න පුළුවන්. ඒ වගේම term-frequency adjustments නිසා model එක දන්නවා, records දෙකකම "Smith Trading" කියලා නම තියෙන එක, records දෙකකම "Zubrowka Holdings" කියලා තියෙන එකට වඩා දුර්වල සාක්ෂියක් කියලා. මොකද පළවෙනි නම සුලබයි, දෙවෙනි එක දුර්ලභයි.
Scoring එක එහෙමයි. Scale එක බලාගන්නේ blocking. හැම record එකක්ම අනිත් හැම එකක් එක්කම compare කරනවා වෙනුවට, ඔයා Splink ට blocking rules දෙනවා — records දෙකක් compare කරන්න ගන්නවත් කලින් ඒ දෙකටම පොදු වෙන්න ඕන, ලාභෙට check කරන්න පුළුවන් conditions. "එකම city එක" නැත්නම් "නමේ මුල් අකුරු තුන එකයි" වගේ ඒවා. කිසිම block එකක් පොදු නැති records කවදාවත් compare වෙන්නේ නෑ. Comparisons බිලියන 500 ක් මිලියන කීපයකට අඩු වෙන්නේ ඒ නිසා. මෙතන මතක තියාගන්න ඕනම දේ: blocking එකෙන් තීරණය වෙන්නේ මොන pairs ද score වෙන්නේ කියන එක විතරයි. Score වුණ pair එකක් ඇත්තටම match එකක්ද කියලා තීරණය කරන්නේ තාමත් statistical model එක.
අන්තිම පියවර clustering. Scoring එකෙන් එන්නේ pairs: A, B එක්ක match වෙනවා; B, C එක්ක match වෙනවා. Splink මේවා graph එකක edges විදිහට අරගෙන, එකිනෙකට සම්බන්ධ records clusters වලට group කරනවා. හැම cluster එකක්ම එක real-world entity එකක්. ඒකේ cluster id එක තමයි ඔයාගේ master key එක.
අපි හදලා බලමු: company master එකක්
දැන් අපි ඇත්තටම මේක හදමු. මම පටන් ගන්නේ DuckDB එක්ක, මොකද ඒක කිසිම setup එකක් නැතුව ඕනම තැනක run වෙනවා. ඊට පස්සේ Spark/Fabric වලට යද්දී කරන්න ඕන වෙනස පෙන්නන්නම්. මුලින්ම install කරගන්න:
pip install splink
ඔයා දැනටමත් sources ඔක්කොම එකතු කරලා, clean කරලා (ඒ ගැන තව ටිකකින් කතා කරමු) මේ columns තියෙන එක table එකකට දාලා තියෙනවා කියලා හිතමු: unique_id, source_system, source_id, company_name, city, postcode, registration_no. unique_id එක මුළු combined table එකේම unique වෙන්න ඕන — source එකයි source id එකයි එකට concatenate කරපු සරල එකක් වුණත් හොඳටම ඇති.
Model එක define කරමු
import splink.comparison_library as cl
from splink import DuckDBAPI, Linker, SettingsCreator, block_on

db_api = DuckDBAPI()

settings = SettingsCreator(
    link_type="dedupe_only",
    comparisons=[
        cl.NameComparison("company_name"),
        cl.JaroWinklerAtThresholds("city", score_threshold_or_thresholds=[0.9]),
        cl.ExactMatch("postcode").configure(term_frequency_adjustments=True),
        cl.ExactMatch("registration_no"),
    ],
    blocking_rules_to_generate_predictions=[
        block_on("city"),
        block_on("postcode"),
        block_on("substr(company_name, 1, 4)"),
    ],
)
මම මේ choices කළේ ඇයි කියලා පොඩ්ඩක් කියන්නම්. link_type="dedupe_only" වලින් Splink ට කියන්නේ ඔක්කොම data තියෙන්නේ එක table එකක, ඕනම record එකක් ඕනම record එකක් එක්ක match වෙන්න පුළුවන් කියලා — sources කිහිපයක් දැනටමත් එකට stack කරලා තියෙනකොට ඔයාට ඕන වෙන්නේ ඒකමයි. Comparisons වලින් කියවෙන්නේ හැම field එකක්ම score කරන්නේ කොහොමද කියලා: company name එකට ඒ වැඩේටම හදපු name comparator එකක්, city එකට fuzzy comparator එකක්, structured fields වලට exact matches. Postcode එකේ term-frequency adjustment එක නිසා, දුර්ලභ postcode එකක් පොදු වෙන එකට, සුලබ postcode එකක් පොදු වෙනවට වඩා වැඩි වටිනාකමක් ලැබෙනවා. Blocking rules වලින් කියන්නේ records දෙකක් compare වෙන්නේ ඒ දෙකට එකම city එකක්, එකම postcode එකක්, නැත්නම් නමේ මුල් අකුරු හතර පොදු නම් විතරයි කියලා. ඒ නිසා ඇත්ත match එකක් බොහෝ විට ඔය දැල් වලින් අඩුම තරමේ එකකටවත් අහු වෙනවා. ඒ අතරේ junk pairs වැඩි හරියක් ලාභෙටම අයින් වෙනවා.
Train කරමු
linker = Linker(your_dataframe, settings, db_api)

# Rough estimate of how rare matches are overall
linker.training.estimate_probability_two_random_records_match(
    [block_on("registration_no")], recall=0.7
)

# Learn the u values (agreement by chance) from random pairs
linker.training.estimate_u_using_random_sampling(max_pairs=1e6)

# Learn the m values (agreement among true matches) via EM
linker.training.estimate_parameters_using_expectation_maximisation(
    block_on("city")
)
linker.training.estimate_parameters_using_expectation_maximisation(
    block_on("postcode")
)
මෙතන pattern එක හිතලාම කරපු එකක්. u අගයන් ඉගෙනගන්නේ random pairs sample කරලා. Definition එක අනුවම ඒ pairs ඔක්කොම වගේ non-matches. m අගයන් ඉගෙනගන්නේ EM වලින්. ඒක එක පාරකට වඩා run කරනවා, හැම පාරම වෙනස් field එකක් උඩ block කරලා. එතකොට හැම field එකක්ම train වෙන්නේ ඒ field එක උඩ block නොකරපු pairs වලින්. මේ ටික ඉවර වුණාම model එක සම්පූර්ණයෙන් train වෙලා, ඔයාට ඒක ඇතුළට එබිලා බලන්න පුළුවන් — linker.visualisations.match_weights_chart() එකෙන් හැම field එකක්ම කොච්චර දායක වෙනවද කියලා හරියටම පෙන්නනවා. Results අමුතු විදිහට පේනකොට මම මුලින්ම බලන්නේ ඒක.
Predict කරලා cluster කරමු
pairwise = linker.inference.predict(threshold_match_probability=0.9)

clusters = linker.clustering.cluster_pairwise_predictions_at_threshold(
    pairwise, 0.95
)

df = clusters.as_pandas_dataframe()
දැන් df එකේ හැම input row එකකටම cluster_id එකක් අමුණලා තියෙනවා. ඒ cluster_id එක තමයි ඔයාගේ master company id එක. ඔයාගේ transactions වලට ආපහු link කරන cross-reference table එක හදන්න, columns තුනක් විතරක් තියාගත්තම ඇති:
xref = df[["source_system", "source_id", "cluster_id"]]
හැම source එකකම හැම transaction එකක්ම තාමත් join වෙන්නේ ඒකේ original (source_system, source_id) එකෙන්. මේ xref එක හරහා ඒක එක master company එකකට roll up වෙනවා. Source transaction tables වලට ඔයා අත තියන්නවත් ඕන නෑ.
Microsoft Fabric හෝ Spark උඩ run කරනවා නම්
Model definition එකයි training/predict calls ටිකයි හරියටම එක වගේ. වෙනස් වෙන්නේ backend එක විතරයි: Spark extras install කරලා, DuckDB connection එකක් වෙනුවට ඔයා ළඟ දැනටමත් තියෙන Spark session එක Splink ට දෙනවා.
pip install 'splink[spark]'
from splink import Linker, SettingsCreator, SparkAPI, block_on
import splink.comparison_library as cl

# In Fabric a `spark` session already exists in the notebook
spark_df = spark.createDataFrame(your_pandas_df)

linker = Linker(spark_df, settings, db_api=SparkAPI(spark_session=spark))
එතැන් ඉඳන් linker.training..., linker.inference.predict(), clustering call එක ඔක්කොම කලින් වගේමයි. Results ගන්නේ results.as_spark_dataframe() වලින්. Fabric වලට විතරක් ආවේණික පොඩි කරදරයක් තියෙනවා: Splink ගේ string-similarity functions සමහරක් එන්නේ jar එකක් ඇතුළේ compiled Spark functions විදිහට. Managed environment එකක ඒ jar එක register කරන එක ටිකක් අමාරු වෙන්න පුළුවන්. Comparator එකක් error දෙනවා නම්, jar එක හදාගන්නකන් ඒක ඕන නොවෙන comparators (exact match සහ Levenshtein-based ඒවා) පාවිච්චි කරන්න. නැත්නම් මුලින්ම sample එකක් අරන් DuckDB වල model එක test කරලා, full volume එකට විතරක් Spark වලට යන්න.
ඇත්තටම වැදගත් වෙන්නේ මේ ටික
Code එක ලියන එක තමයි ලේසිම කොටස. Projects සාර්ථක වෙන්නෙත්, කාටවත් නොදැනී වැරදෙන්නෙත් මෙතනින්.
Link කරන්න කලින් clean කරන්න. Splink කියන්නේ data-cleaning tool එකක් නෙවෙයි. Raw values කෙලින්ම දාන එක තමයි නරක results එන්න තියෙන පොදුම හේතුව. කම්මැලි වැඩේ මුලින්ම කරලා ඉවර කරන්න: ඔක්කොම upper-case කරන්න, whitespace trim කරන්න, legal suffixes (LTD, INC, LLC, GMBH, PLC) නමේම තියන්නේ නැතුව වෙනම field එකකට ගලවලා දාන්න, addresses standardise කරන්න. Acme සහ ACME LIMITED දාපු model එකකට, ACME සහ ACME දාපු model එකකට වඩා ගොඩක් මහන්සි වෙන්න වෙනවා.
ශක්තිමත් identifiers හොයාගෙන ඒවා පාවිච්චි කරන්න. මොකක් හරි source එකක tax number එකක්, company registration number එකක්, නැත්නම් website domain එකක් තියෙනවා නම්, ඒ field එක නමයි city එකයි දෙකම එකතු කළාටත් වඩා වටිනවා. විශ්වාස කරන්න පුළුවන් පොදු identifier එකකින් ඔයාට ලොකු m එකකුයි බිංදුවට කිට්ටු u එකකුයි ලැබෙනවා — ශක්තිමත් සාක්ෂියකට පොතේ තියෙන definition එකම ඒක. සමහර විට ඔයාට වැඩිය ඕනත් නොවෙන name-similarity thresholds tune කරන්න දවසක් නාස්ති කරන්න කලින්, ඔයා ළඟ මොනවද තියෙන්නේ කියලා බලන්න.
Blocking rules හදන්න එක rule එකක් විදිහට නෙවෙයි, set එකක් විදිහට. කිසිම blocking rule එකක් තනියම perfect වෙන්න ඕන නෑ. Set එකෙන් කරන්න ඕන, හැම ඇත්ත match එකක්ම අඩුම තරමේ එක rule එකකටවත් අහු කරගන්න එක විතරයි. මෙතන trade-off එක ඇත්තටම තියෙනවා: loose rules (city එක විතරක් උඩ block කරන එක වගේ) ගොඩක් pairs හදලා ඔක්කොම slow කරනවා. Tight rules (city එක සහ මුල් අකුර) වේගවත් වුණාට, block කරපු field එකේ එකඟ නොවෙන matches මඟහැරෙන්න ඉඩ තියෙනවා. මොනවත් run කරන්න කලින්ම, එක එක rule එකෙන් comparisons කීයක් හැදෙයිද කියලා Splink ට කියන්න පුළුවන්. ඒක පාවිච්චි කරලා මුළු ගණන සාධාරණ range එකක තියාගන්න — සාමාන්යයෙන් බිලියන ගණන් නෙවෙයි, මිලියන දස ගණන්.
Threshold එක හිතලා බලලා තෝරන්න, review band එකකුත් තියාගන්න. Match score එක yes/no එකක් විදිහට ගන්න එපා. Thresholds දෙකක් තෝරගන්න: උඩ එකට වඩා වැඩි නම් match එකක් විදිහට auto-accept කරන්න; පහළ එකට වඩා අඩු නම් auto-reject කරන්න; ඒ දෙක අතර තියෙන ඒවා මනුස්සයෙක් ළඟට යවන්න. ඇත්තටම සැක හිතෙන cases තියෙන්නේ ඔය මැද band එකේ. ඒවා නෑ වගේ ඉන්න ගියාම තමයි වැරදි merges හොරෙන් master table එකට රිංගන්නේ. Splink ගේ waterfall chart එක, එක pair එකක score එක field එකෙන් field එක කඩලා පෙන්නනවා. ඒ review එක කරන කෙනාගේ අතට මම දෙන්නේ ඒ tool එක.
Runs අතර master ids වෙනස් නොවී තියාගන්න. මේ පාඩම ගොඩක් අය ඉගෙනගන්නේ බැට කාලා. Splink ගේ cluster_id එක ඊළඟ පාර pipeline එක run කරද්දී එකම අගය වෙයි කියලා කිසිම සහතිකයක් නෑ. හැම run එකකදීම ඔයාගේ master id එක ඒ run එකේ cluster id එකෙන් ඇස් පියාගෙන overwrite කළොත්, හැම transaction link එකක්ම කැඩෙනවා. විසඳුම තමයි ඔයාගේම master id table එකක් persist කරලා, හැම run එකකදීම අලුත් clusters, කලින් run එකත් එක්ක තියෙන overlap එක අනුව දැනට තියෙන master ids වලට map කරන එක. අලුත්ම master id එකක් හදන්නේ ඇත්තටම අලුත් entity එකකට විතරයි. මේක මුල් දවසේ ඉඳන්ම හදන්න; පස්සේ ආපහු දාන්න ගියොත් ලොකු කරදරයක්.
Evaluate කරන්න, නිකම්ම විශ්වාස කරන්න එපා. සම්පූර්ණ labelled set එකක් නැතත් sanity-check කරන්න පුළුවන්. Pairs සිය ගාණක් අතින් label කරන්න. Cluster sizes අරගෙන, සැක හිතෙන තරම් ලොකු clusters තියෙනවද බලන්න (බොහෝ විට ඒකෙන් පේන්නේ blocking rules දෙකක් එකතු නොවිය යුතු දේවල් එකට merge කරලා කියලා). Splink ගේ cluster studio dashboard එකෙන් ඇත්ත clusters ඇහින්ම බලන්න. Aggregate metrics වල ලස්සනට පේන model එකක් වුණත්, එකම building එකේ තියෙන වෙනස් company දෙකක් කාටවත් නොදැනී merge කරනවා වෙන්න පුළුවන්.
Splink හරියන්නේ නැති තැන්
Splink මැජික් එකක් නෙවෙයි. සමහර අවස්ථා වලදී ඒකට කරන්න දෙයක් නෑ. ඔයා ළඟ තියෙන එකම field එක free-text "company name" column එකක් නම් — city එකක් නෑ, id එකක් නෑ, address එකක් නෑ — Splink ට වැඩ කරන්න ලොකු දෙයක් ඉතුරු වෙන්නේ නෑ. මොකද මුළු approach එකම රඳා පවතින්නේ එකිනෙකින් ස්වාධීන signals කිහිපයක් එකිනෙකට සාපේක්ෂව කිරලා බලන එක මත. තනි bag-of-words column එකක් link කරන්න මේක හදලා නෑ කියලා authors ලාම කෙලින්ම කියනවා. Fields එකිනෙකට තදින් correlated නම් ඒකත් Splink දුර්වල කරනවා, මොකද model එක assume කරන්නේ හැම field එකක්ම ස්වාධීන සාක්ෂියක් එකතු කරනවා කියලා. ඔයාගේ "city" සහ "postcode" හැමවෙලේම එකඟ වෙනවා නම්, ඇත්තටම ඒ දෙපාරක් ගණන් කරපු එකම signal එක. ඒ වගේම, stewards ලාට merges approve කරන්න workflow එකයි audit එකයි ඇතුළත්ම ලස්සන business-user interface එකක් ඕන නම්, ඇත්තටම paid MDM platforms විකුණන්නේ ඒක තමයි. Splink ඔයාට දෙන්නේ matching engine එක, ඒ වටේ තියෙන front office එක නෙවෙයි.
ඒත් ගොඩක් teams වලට ඇත්තටම තියෙන ප්රශ්නෙට — sources කිහිපයක්, වෙනස් ids යටතේ පොඩ්ඩක් වෙනස් spellings එක්ක එකම entities, එක key එකක එල්ලෙන්න ඕන transaction layer එකක් — Splink අමාරුම 90% කරලා දෙනවා. ඒකට යන්නේ ඔයා ළඟ දැනටමත් තියෙන compute එක විතරයි. Data clean කරන්න, හොඳ signals ටිකක් දෙන්න, thresholds ගැන ඇහැ ඇරගෙන ඉන්න, master keys වෙනස් නොවී තියාගන්න. ඔය ටික හරියට කළොත් වැඩේ ගොඩක් දුරට ඉවරයි.