allaboutspark
නමිඳු නදීෂාන්

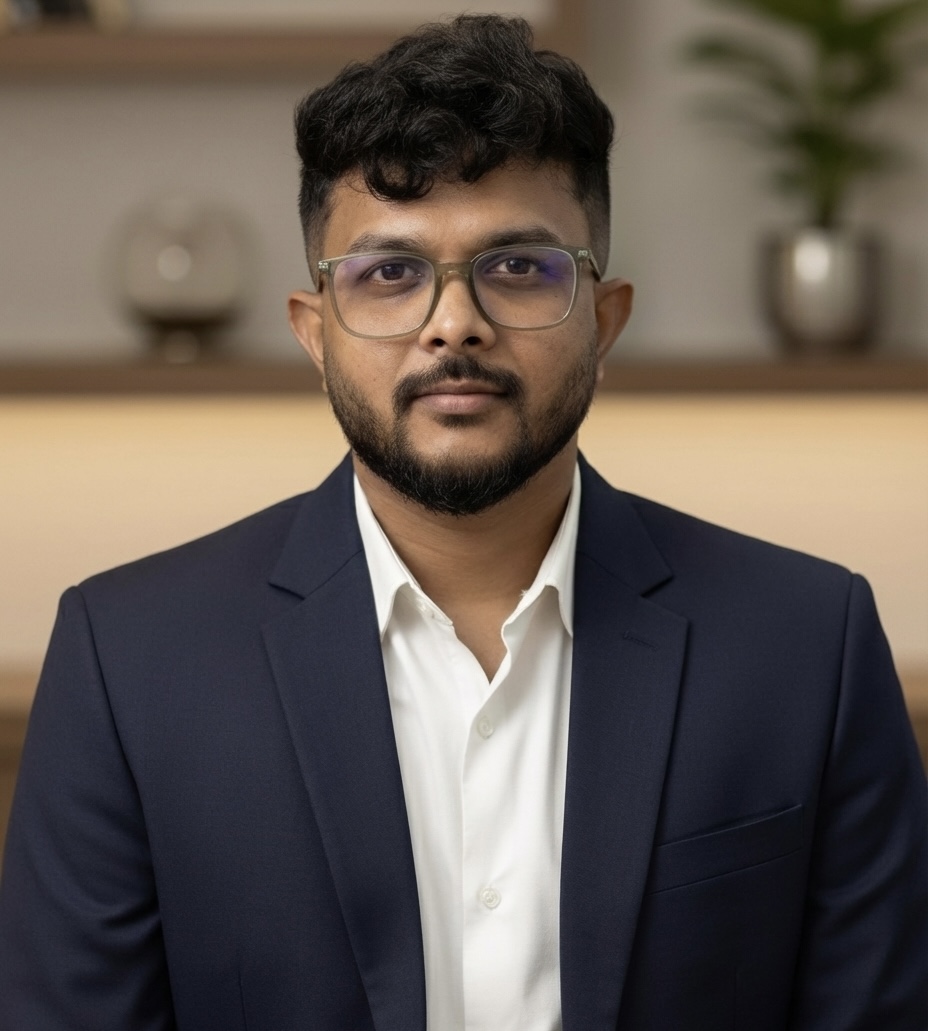
ආයුබෝවන්, මම නමිඳු

මම කොළඹ base වෙලා වැඩ කරන Lead Data Engineer කෙනෙක්. මම වැඩ කරන tech stack එක, මේ දවස්වල කියවන පොත්, වගේම ජීවිතෙන් ඉගෙන ගන්න දේවල් ගැන තමයි මම මෙතන ලියන්නේ. මේකේ තියෙන හැමදෙයක්ම 100% ක් මගේම අදහස්. මා ගැන තව.

ලිපි

මම කොළඹට හරියන Free Route Optimizer එකක් හැදුවා. හැබැයි මේකට දැන් Real Traffic Data ඕනේ.

පහුගිය මාස කිහිපය පුරාවටම මම වැඩ කළේ කොළඹ delivery riders ලට පාවිච්චි කරන්න පුළුවන් Open-source route optimizer එකක් හදන්න. මේකෙන් ඩිලිවරි කරන්න තියෙන තැන්වලට යන්න ඕනේ හොඳම පිළිවෙළ ප්ලෑන් කරනවා විතරක් නෙවෙයි, දවසේ වෙලාව සහ නිවාඩු දවස් අනුව traffic එකත් predict කරනවා. විශේෂම දේ තමයි මේක පාවිච්චි කරන්න කිසිම ගාස්තුවක් යන්නේ නැහැ.

Projectsකියවන්න විනාඩි 4+ තවත් ගැඹුරට

අලුත් Architecture එකක 'වාසි' පමණක් පෙන්වා දීම නවත්වන්න

Daniel Kahneman ගේ "Thinking, Fast and Slow" පොත කියෙව්වට පස්සේ, මම Technical Pitches කරන විදිහ සහ Leadership Buy-in (කළමනාකාරීත්වයේ අනුමැතිය) ලබාගන්න පාවිච්චි කරන ක්‍රමය සම්පූර්ණයෙන්ම වෙනස් වුණා. මිනිස්සුන්ගේ මොළය ස්වභාවයෙන්ම හැදිලා තියෙන්නේ 'Loss Aversion' වලට අනුව බව ඔහු ඒකෙන් ඔප්පු කරලා පෙන්වනවා—ඒ කියන්නේ, යමක් අලුතෙන් ලැබෙනවට වඩා, තමන්ට තියෙන යමක් අහිමි වීමෙන් දැනෙන මනෝවිද්‍යාත්මක වේදනාව දෙගුණයක් වැඩියි කියන එක. ඉතින් ඔයාට ඕනේ නම් Stakeholders ලා අර ලෙඩ දෙන පරණ Legacy systems තවදුරටත් බදාගෙන ඉන්න එක නවත්වන්න, අනාගතේ ලැබෙන්න තියෙන 'වාසි' විකුණන එක නවත්වලා, දැනටමත් දවස ගානේ අපිට සිද්ධ වෙන 'නාස්තිය සහ පාඩුව' (active bleed) ඔවුන්ට හොඳට පේන්න අරින්න ඕනේ.

පොත්කියවන්න විනාඩි 2+ තවත් ගැඹුරට

අකුරු අඩුවෙන්, අවධානය වැඩියෙන්: ඕනෑම කෙනෙකුට ඔබේ හඬ ඇසෙන්න සලස්වන හැටි.

බොහෝ දෙනෙක් වචන 200ක් කියවූ වහාම ඔබේ ඊමේල් පණිවිඩ කියවීම අතහැර දමති. Smart Brevity සංකල්ප භාවිතයෙන් අනවශ්‍ය දේ කපා හැර, ඔබේ ප්‍රධාන පණිවිඩය ක්ෂණිකවම පාඨකයාට ලබා දීමට ඔබට හැකියාව ලැබේ. කාගේත් අවධානය දිනාගැනීමට සහ ඉක්මන් ප්‍රතිචාර ලබාගැනීමට මා මගේ සන්නිවේදන රටාව වෙනස් කළ ආකාරය මෙයින් දැනගන්න.

පොත්කියවන්න විනාඩි 2+ තවත් ගැඹුරට

Data scientist රස්සාවට, ඒ කියන්නේ "Sexiest Job of the 21st Century" එකට, ඇත්තටම වෙන්නේ මොකක්ද?

2012 දී Harvard Business Review එක data scientist රස්සාව "sexiest job of the 21st century" කියලා නම් කළ එක ගොඩක් දෙනා දන්නවා. ඒකට හේතුව සරලයි: big data වලින් තේරුමක් ගන්න පුළුවන් අය හිටියේ හරිම ටිකයි. ඊට පස්සේ Generative AI එකපාරටම කරළියට පැන්නා. අද මේ role එක මැරිලා නැහැ, ඒත් අපි කලින් දැනගෙන හිටපු "data scientist" කියන definition එක නම් නිල වශයෙන්ම ඉවරයි.

Career සහ අලුත් අභියෝගකියවන්න විනාඩි 2

AI සල්ලි අපිටත් බෙදෙයි කියන මායාව: ලංකාවේ IT sector එක ඇස් පියාගෙන අර්බුදයකට දුවන්නේ ඇයි?

Anthropic එක ඩොලර් බිලියන 48ක් විතර වටිනා equity public benefit fund එකකට දෙනවා කියලා දීපු පොරොන්දුවයි, ඒකේ CEO AI වලින් funded Universal Basic Income (UBI) එකක් වෙනුවෙන් පෙනී ඉන්න එකයි Silicon Valley එකේ නිකන් thought experiments නෙවෙයි. ඒවා හයියෙන්ම නාද වෙන අනතුරු සීනු. ලංකාව වගේ දියුණු වෙමින් තියෙන ආර්ථිකයක් ජීවත් වෙන්න යැපෙන්නේ හරියටම මොන jobs මතද, Generative AI වේගයෙන් අතුගාලා දාන්නේ ඒ jobs ම තමයි.

Career සහ අලුත් අභියෝගකියවන්න විනාඩි 2+ තවත් ගැඹුරට

ලංකාවේ Tech Sector එකේ Macroeconomic පදනම: Growth, Brain Drain සහ 2030 ඉලක්කය දත්ත වලින් කියවමු

ලංකාවේ Information Technology සහ Business Process Management (IT/BPM) sector එක ගැන කතාබහ ගොඩක් වෙලාවට පැද්දෙන්නේ අන්ත දෙකක් අතර. එක පැත්තකින් "$5 Billion Digital Dawn" වගේ බලාපොරොත්තු පුම්බපු promotional කතා, අනෙක් පැත්තෙන් skilled talent රට දාලා යන එකෙන් වෙන විනාශය ගැන බය උපදවන අනතුරු ඇඟවීම්. 2026 දී මේ sector එක ඇත්තටම යන්නේ කොයි පැත්තටද කියලා තේරුම් ගන්න නම්, කට කතා පැත්තකින් තියලා raw data දිහා බලන්නම වෙනවා.

Career සහ අලුත් අභියෝගකියවන්න විනාඩි 8

Fabric IQ මුල ඉඳන්ම: මොකක්ද, ඇයි වැදගත්, ඔයාගේ පළමු Ontology එක හදාගන්නේ කොහොමද

Data පැත්තේ ටික කාලයක් වැඩ කරලා තියෙනවා නම්, මේ නිහඬ කරදරය ඔයා හොඳට දන්නවා. Warehouse එක පිරිලා තියෙන්නේ factsales, dimstore, dimproducts වගේ tables වලින්. ඒත් business එක කතා කරන්නේ customers, shipments, cold-chain breaches ගැන. කවුරුහරි "සරල" ප්‍රශ්නයක් ඇහුවම, domain expert කෙනෙක්ට වාඩි වෙලා ඒක joins, filters, column names වලට හරවන්න වෙනවා. හැමෝගෙම වැඩ හිර කරන්නේ හැම පාරම ගෙවන්න වෙන මේ translation බද්ද — Fabric IQ හදලා තියෙන්නෙත් හරියටම ඒක නැති කරන්න.

Microsoft Fabricකියවන්න විනාඩි 17

Skewed joins වලට Spark එකේ Adaptive Query Execution උත්තර දෙන හැටි

Production එකේ Spark එක්ක ටික කාලයක් වැඩ කරලා තියෙනවා නම් මේ සීන් එක ඔයාට අලුත් නෑ. සාමාන්‍යයෙන් විනාඩි අටෙන් ඉවර වෙන job එකක් එක පාරටම "199/200 tasks completed" එකේ විනාඩි හතළිස් පහක් තිස්සේ හිරවෙලා.

Apache Sparkකියවන්න විනාඩි 12

MDM tool එකක් ගන්නේ නැතුව අවුල් records match කරමු: Splink ගැන practical guide එකක්

කවදා හරි දවසක ඕනම data team එකකට මේ ප්‍රශ්නෙට මූණ දෙන්න වෙනවා. ඇත්තටම එකම customer කෙනෙක්, company එකක්, patient කෙනෙක් systems තුන හතරක ඉන්නවා, ඒත් එයාව අඳුරගන්නේ කොහොමද කියන එක ගැන එක system එකක්වත් අනිත් ඒවා එක්ක එකඟ නෑ. CRM එකේ ඒක ACME Corp, id එක 1042. Billing system එකේ Acme Corporation Ltd, id එක BX-77. කවුරුහරි ගිය අවුරුද්දේ import කරපු spreadsheet එකක acme corp. කියලා තියෙනවා, විශ්වාස කරන්න පුළුවන් id එකක් නම් නෑ. ඔයාට ඕන එක master record එකක්, ඒ වගේම හැම transaction එකක්ම ආපහු ඒ record එකට සම්බන්ධ කරන්න ක්‍රමයක්.

Tools සංසන්දනකියවන්න විනාඩි 12

Research සටහන්

AI එකෙන් ලියපු

මම හදපු AI agent කෙනෙක් official docs වලින් ලියන කෙටි සාරාංශ. හැම එකකම sources දාලා තියෙනවා, ඒත් මම ඒවා edit කරන්නේ නැහැ. ඒ නිසා පටන් ගන්න තැනක් විදිහට විතරක් බලන්න. මේ notes තියෙන්නේ ඉංග්‍රීසියෙන් විතරයි.

ඔයා කියවපු දේවල් අනුව

මේ device එකේ ඔබ open කරපු ලිපි අනුව තෝරපු ඒවා. ඒක සම්බන්ධ වෙන්නේ නමක් නැති id එකකට, ඔබට නෙවෙයි.

අලුත් ලිපි email එකෙන් ගන්න

මම අලුත් දෙයක් publish කරාම කෙටි email එකක්, දවසකට එක පාරක් වත් වැඩියෙන් නෑ. ඔබට වැදගත් මාතෘකා විතරක් තෝරන්න, නැත්නම් ඔක්කොම ගන්න කිසිම එකක් තෝරන්න එපා.

Confirm කරන්න ඕන නෑ. හැම email එකකම unsubscribe link එකක් තියෙනවා.