Skewed joins වලට Spark එකේ Adaptive Query Execution උත්තර දෙන හැටි
Production එකේ Spark එක්ක ටික කාලයක් වැඩ කරලා තියෙනවා නම් මේ සීන් එක ඔයාට අලුත් නෑ. සාමාන්යයෙන් විනාඩි අටෙන් ඉවර වෙන job එකක් එක පාරටම "199/200 tasks completed" එකේ විනාඩි හතළිස් පහක් තිස්සේ හිරවෙලා.
Production එකේ Spark එක්ක ඇත්තටම වැඩ කරලා තියෙනවා නම්, මේ සීන් එක ඔයාට හොඳට පුරුදුයි. සාමාන්යයෙන් විනාඩි අටෙන් ඉවර වෙන job එකක් එක පාරටම "199/200 tasks completed" එකේ විනාඩි හතළිස් පහක් තිස්සේ හිරවෙලා. Cluster එක දිහා බැලුවාම නිකන් idle වගේ. එක executor එකක් විතරක් 100% CPU එකේ මොකක්දෝ හෙමින් හෙමින් හපනවා, අනිත් හතළිහම කිසි වැඩක් නැතුව බලන් ඉන්නවා. අන්තිමට එක්කෝ ගොඩක් පරක්කු වෙලා ඉවර වෙනවා, නැත්නම් out-of-memory error එකක් දීලා මැරෙනවා.
අර අන්තිමට ඉතුරු වෙන straggler task එක කියන්නේ බොහෝ වෙලාවට join එකක තියෙන data skew එකක ලක්ෂණයක්. Spark 3.0 ඉඳන් මේකටම කියලා හදපු feature එකක් තියෙනවා, ඒකට ඔයාගේ business logic එකේ එක line එකක්වත් වෙනස් කරන්න ඕන නෑ. ඒක control කරන්නේ spark.sql.adaptive.skewJoin.enabled එකෙන්. ඒක Adaptive Query Execution (AQE) කියන ලොකු framework එකේ කොටසක්.
මේ article එකෙන් මම කතා කරන්නේ skew කියන්නේ ඇත්තටම මොකක්ද, ඒක මෙච්චර රිදවන්නේ ඇයි, AQE එක runtime එකේදී ඒක අඳුරගෙන හදන්නේ කොච්චර බුද්ධිමත් විදියටද කියන එක ගැන. Examples ටික concrete විදියටම තියාගන්නම්, numbers ටිකත් කොළයක ලියාගෙන follow කරන්න පුළුවන් තරමට පොඩියට.
මුලින්ම, Spark data join කරන විදිය පොඩ්ඩක් මතක් කරගමු
Skew තේරුම් ගන්න නම් මුලින්ම sort-merge join එක ගැන අවබෝධයක් ඕන. ලොකු tables දෙකක් join කරද්දි Spark default විදියට යන්නේ මේ strategy එකට.
උදාහරණයක් විදියට, events table එකක් users table එකක් එක්ක user_id එකෙන් join කරන්න ඕන කියමු. දෙකෙන් එකක්වත් broadcast කරන්න තරම් පොඩි නෑ. එතකොට Spark කරන්නේ මෙහෙමයි:
-
Join key එකෙන් පැති දෙකම shuffle කරනවා. හැම row එකක්ම
user_idඑකෙන් hash කරනවා, එකම value එකට hash වෙන rows එකම partition එකට යනවා. මෙතන තියෙන ප්රධාන guarantee එක තමයි එකuser_idඑකකට අදාළ rows ඔක්කොම, පැති දෙකේම, එකම partition එකකට එකතු වෙනවා කියන එක. -
හැම partition එකක්ම key එකෙන් sort කරනවා.
-
Sort කරපු streams දෙක merge කරලා, match වෙන rows එළියට දෙනවා.
මෙන්න දළ flow එක:
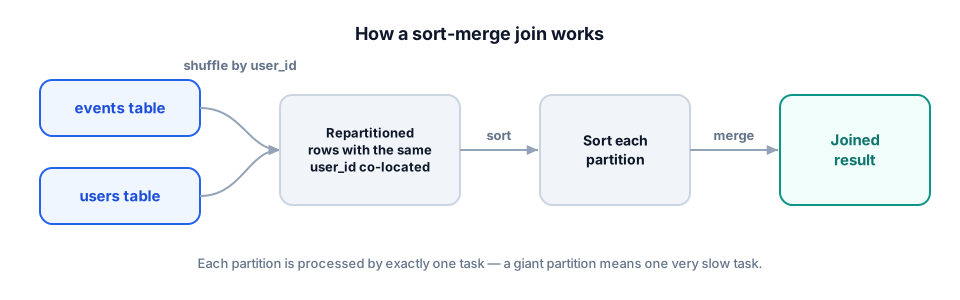
මෙතනින් අල්ලගන්න ඕන වැදගත්ම දේ මේකයි: එක join partition එකක් process කරන්නේ එක task එකක් විතරයි. ඒ partition එක අතිවිශාල නම්, ඒ එක task එකටම අතිවිශාල වැඩ කන්දරාවක් කරන්න වෙනවා, අනිත් tasks වලට උදව් කරන්න කිසිම ක්රමයක් නෑ. ඒවා තමන්ගේ පොඩි partitions ඉවර කරලා කලින්ම ගෙදර ගිහින්.
එහෙනම් data skew කියන්නේ මොකක්ද?
සරලවම කිව්වොත්, data skew කියන්නේ partitions අතර rows අසමාන විදියට බෙදිලා තියෙන එක. හැමදේම හරියට තියෙන ලෝකයක නම් shuffle එකකින් පස්සේ හැම partition එකක්ම දළ වශයෙන් එකම size එකේ. ඒත් ඇත්ත ලෝකයේ සමහර keys අනිත් ඒවාට වඩා ගොඩක් වැඩියෙන් එනවා.
පොත්වල තියෙන සම්භාව්ය උදාහරණය තමයි "catch-all" key එකක්. අපේ events table එක web analytics data කියලා හිතන්න. Anonymous visitors ඔක්කොම record වෙන්නේ user_id = 0 විදියට. Log in වෙලා ඉන්න හැම user කෙනෙක්ම events සිය ගාණක් විතර generate කරද්දි, anonymous bucket එක generate කරන්නේ මිලියන දෙසීයක්.
Spark user_id එකෙන් shuffle කරාම partition sizes පේන්නේ මෙහෙමයි:
Partition 0   ██ 100 MB
Partition 1   ██ 110 MB
Partition 2   ██  95 MB
Partition 3   ████████████████████████████████████  2000 MB   ← user_id = 0 lives here
Partition 4   ██ 105 MB
Partition 5   ██  98 MB
...
Partition 3 එක අල්ලපු partitions වලට වඩා විසි ගුණයක් ලොකුයි. ඒක process කරන task එකට දළ වශයෙන් විසි ගුණයක් වැඩි වෙලාවක් යනවා, memory එකේ විසි ගුණයක් වැඩි data තියාගන්න වෙනවා, disk එකට spill වෙන්න හරි සම්පූර්ණයෙන්ම වැටෙන්න හරි ලොකු ඉඩක් තියෙනවා. ඒ අතරේ ඔයාගේ අනිත් cores 199 කාලෙකට කලින් වැඩ ඉවර කරලා, කිසි දෙයක් නොකර සල්ලි පුච්චනවා.
මේක තමයි straggler problem එක. පැහැදිලි හේතුවක් නැතුව Spark stage එකක් හෙමින් යනවා නම්, ඒකට තියෙන බහුලම හේතුව මේකයි.
"Partitions වැඩි කළා නම් හරි" කියන එක වැඩ නොකරන්නේ ඇයි
මුලින්ම හිතට එන සාධාරණ අදහස spark.sql.shuffle.partitions වැඩි කරන එක. ඒකෙන් වැඩක් නෑ. user_id = 0 rows මිලියන දෙසීයම hash වෙන්නේ එකම value එකකට, ඉතින් ඔයා partitions කීයක් හැදුවත් ඒ ඔක්කොම යන්නේ එකම partition එකකට. අන්තිමට ඔයාට ලැබෙන්නේ තව හිස් partitions ටිකක් සහ කලින් තිබ්බ අර ලොකු partition එකම විතරයි.
කලින් කාලේ මේකට තිබ්බ විසඳුම salting — hot key එකට random suffix එකක් එකතු කරලා ඒක partitions කිහිපයකට බෙදලා යවනවා, ඊට පස්සේ results ආපහු එකතු කරන්න අමතර වැඩ ටිකක් කරනවා. ඒක වැඩ කරනවා තමයි, ඒත් හරිම කරදරයි, query එකත් අවුල් කරනවා, ඒ වගේම skewed keys මොනවද කියලා ඔයා කලින්ම දැනගෙන ඉන්නත් ඕන. ඇත්තම ප්රශ්නේ තියෙන්නේ ඒ අන්තිම කාරණේ: skew එක ගොඩක් වෙලාවට දවසින් දවස වෙනස් වෙනවා.
AQE හැදුවේ හරියටම මේ ප්රශ්නේ විසඳන්න.
මෙන්න එනවා Adaptive Query Execution
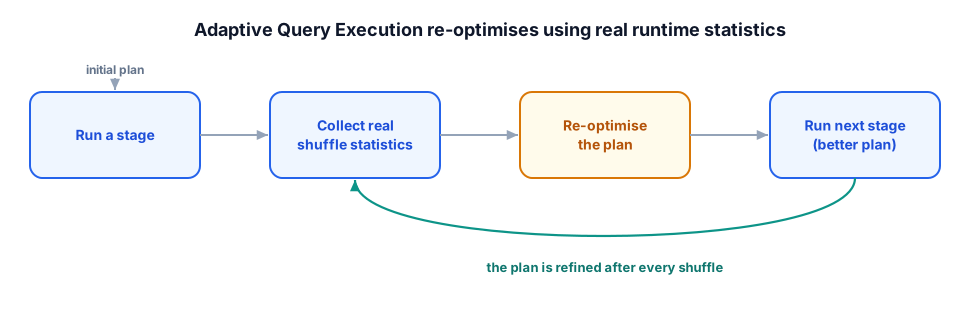
සාම්ප්රදායික Spark optimizer එක (Catalyst) මුළු query එකම plan කරන්නේ execution එකට කලින්, ඒ වෙලාවේ අතේ තියෙන statistics මත. ප්රශ්නේ තියෙන්නේ ඒ statistics ගොඩක් වෙලාවට නැති වෙන එක, පරණ වෙන එක, නැත්නම් කලින් දැනගන්නම බැරි වෙන එක. Shuffle partition එකක size එක ඒකට හොඳම උදාහරණයක් — data ඇත්තටම move වෙන්න පටන් ගත්තාම තමයි ඒක දැනගන්න පුළුවන් වෙන්නේ.
AQE මේ තත්ත්වය වෙනස් කරනවා. Execution එක අතරේ එකතු කරගන්න ඇත්ත statistics පාවිච්චි කරලා runtime එකේදීම plan එක re-optimise කරන්න ඒක Spark ට ඉඩ දෙනවා. හැම shuffle එකකම map stage එක ඉවර වුණාම, හැම partition එකකම නිවැරදි size එක Spark ළඟ තියෙනවා. ඒ අලුත් තොරතුරු පාවිච්චි කරලා AQE වෙනස්කම් තුන් වර්ගයක් කරනවා:
- පොඩි partitions ගොඩක් coalesce කරලා, සාධාරණ size එකක තියෙන partitions ටිකකට එකතු කරනවා.
- Join strategy එක මාරු කරනවා — උදාහරණයක් විදියට, table එකක් ඇත්තටම පොඩියි කියලා දැනගත්තාම sort-merge join එකක් broadcast join එකකට හරවනවා.
- Join එකක තියෙන skewed partitions split කරනවා — මේ article එකේ මාතෘකාව මේකයි.
මේ ඔක්කොගෙම හරය තමයි, AQE react කරන්නේ optimiser එක වෙයි කියලා අනුමාන කරපු දේට නෙවෙයි, ඇත්තටම වුණ දේට.
AQE skewed partition එකක් අඳුරගන්නේ කොහොමද
මෙතන තමයි වැඩේ ලස්සනට practical වෙන්නේ. Join එකක map stage එක ඉවර වුණාම AQE partition sizes ලැයිස්තුව බලනවා. මේ condition දෙකම true නම් විතරයි partition එකක් skewed කියලා mark කරන්නේ:
- Partition එක
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes(default 256 MB) ට වඩා ලොකුයි, සහ - Partition එක median partition size එක මෙන්
spark.sql.adaptive.skewJoin.skewedPartitionFactor(default 5.0) ගුණයකට වඩා ලොකුයි.
Condition දෙකම වැදගත්. ඒ එකින් එක පිටිපස්සේ තියෙන හේතුවත් තේරුම් ගන්න වටිනවා:
- Factor එකෙන් අල්ලගන්නේ අනිත් partitions එක්ක සසඳද්දි අසාමාන්ය විදියට ලොකු partitions. හැම partition එකක්ම 1 GB විතර නම්, ඒ කිසි එකක් skewed නෑ — ඔක්කොම ලොකුයි, එච්චරයි. එකක් split කරලා කිසි balance එකක් ඇති වෙන්නේ නෑ. Factor එක trigger වෙන්නේ මොකක් හරි ඇත්තටම කැපිලා පේනවා නම් විතරයි.
- Threshold එකෙන් වළක්වන්නේ ඔක්කොම පොඩි වෙලාවට තේරුමක් නැතුව split කරන එක. Median partition එක 5 MB යි, එක partition එකක් 40 MB යි කියමු. ඒක median එක මෙන් 8× ක් නිසා factor එක pass වෙනවා, ඒත් 40 MB process කරන එක සුළු දෙයක්. ඒක split කළොත් එකතු වෙන්නේ කිසි ප්රයෝජනයක් නැති overhead එකක් විතරයි. Absolute threshold එකෙන් කියන්නේ "ඇත්තටම ලොකු නැත්නම් කරදර වෙන්න එපා" කියලා.
අපේ උදාහරණයට ආපහු ගියොත්: median එක 100 MB විතර, skewed partition එක 2000 MB.
- 2000 MB > 256 MB ද? ඔව්.
- 2000 MB > 5 × 100 MB = 500 MB ද? ඔව්.
දෙකම true නිසා Partition 3 skewed කියලා mark වෙනවා.
AQE ඒක හදන විදිය: split කරලා, replicate කරලා
මෙන්න ලස්සනම කොටස. events පැත්තේ Partition 3 skewed කියලා AQE දැනගත්තාම, ඒ partition එක පොඩි slices කිහිපයකට split කරනවා. හැම slice එකක්ම දළ වශයෙන් spark.sql.adaptive.advisoryPartitionSizeInBytes තරම් size එකක් (default එක 64 MB; ගණන් සරලව තියාගන්න මම මේ උදාහරණයට 256 MB පාවිච්චි කරනවා).
2000 MB partition එකක් 256 MB slices වලට කැපුවාම slices අටක් විතර ලැබෙනවා. දැන් හැම slice එකක්ම තමන්ගේම task එකකින්, parallel විදියට process කරන්න පුළුවන්.
ඒත් joins වලදී මෙතන පොඩි අවුලක් තියෙනවා. ලොකු පැත්ත විතරක් split කරලා මදි, මොකද events පැත්තේ හැම row එකකටම users පැත්තේ අදාළ rows එක්ක match වෙන්න අවස්ථාව තියෙන්නම ඕන. ඒ නිසා AQE join එකේ අනිත් පැත්තේ match වෙන partition එක replicate කරලා, හැම slice එකකටම ඒකේ full copy එකක් දෙනවා.
![image]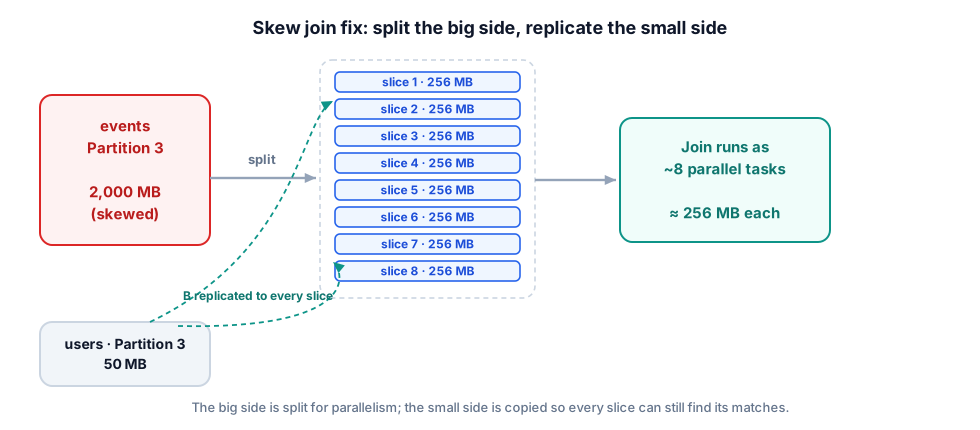
අනිත් පැත්ත අට පාරක් replicate කරන එක මිල අධික වැඩක් කියලා ඔයාට හිතෙන්න පුළුවන්. ප්රායෝගිකව එහෙම වෙන්නේ නැති තරම්, හේතුව මේකයි: skew එක asymmetric. events පැත්තේ user_id = 0 ට rows මිලියන දෙසීයක් තියෙද්දි, users පැත්තේ ඒකට තියෙන්නේ හරියටම එක row එකයි (ඒ partition එකටම hash වුණ වෙන users ටිකකුත් එක්ක — උපරිම megabytes කිහිපයක්). 50 MB partition එකක් අට පාරක් copy කරාම ඔයාට අමතර shuffle reads 400 MB ක් යනවා. ඔයා දැන් නිෂ්ක්රිය කරපු 2 GB රාක්ෂයා එක්ක බැලුවාම ඒක මොකුත්ම නෙවෙයි.
ඉතින් මේ ගනුදෙනුව ඔයාට ගොඩක්ම වාසියි: 2 GB වැඩ කරන එක task එකක් වෙනුවට 256 MB ගානේ වැඩ කරන tasks අටක් එනවා. ඒවා දළ වශයෙන් අටෙන් එකක කාලෙකින් ඉවර වෙනවා, යන්නේ පොඩි, හොඳට වියදම් කරපු overhead එකක් විතරයි.
කලින් සහ පස්සේ, එක ළඟ තියලා බලමු
| Skew join handling නැතුව | Skew join handling එක්ක | |
|---|---|---|
| Hot partition එකට tasks | 1 | ~8 |
| එක task එකකට තියෙන වැඩ | 2000 MB | ~256 MB |
| Stage එකේ wall-clock time | හෙමින් යන එක task එකක් අතේ | Balance කරපු tasks අටෙන් හෙමින්ම යන එකෙන් සීමා වෙනවා |
| එක executor එකක memory pressure | ගොඩක් වැඩියි, spills/OOM වෙන්න ඉඩ වැඩියි | බෙදිලා යනවා, සැහැල්ලුයි |
| Straggler එක run වෙද්දි idle cores | Cluster එකෙන් වැඩි හරියක් | එකක්වත් නෑ |
| ඕන කරන code changes | නෑ (ඔයා salting වලට යයි) | නෑ |
Configuration knobs ටික
මේ ඔක්කොම පාලනය වෙන්නේ configuration වලින්. Default values ගොඩක් workloads වලට ප්රමාණවත්, ඒත් එකින් එක මොකද කරන්නේ කියලා දැනගෙන ඉන්න එක හොඳයි.
| Configuration | Default | ඒකෙන් පාලනය වෙන දේ |
|---|---|---|
spark.sql.adaptive.enabled | true (Spark 3.2.0 ඉඳන්) | AQE එකේ master switch එක. මේක නැතුව පහළ තියෙන කිසිම දෙයක් වැඩ කරන්නේ නෑ. |
spark.sql.adaptive.skewJoin.enabled | true | Skew join handling විශේෂයෙන්ම on කරනවා. |
spark.sql.adaptive.skewJoin.skewedPartitionFactor | 5.0 | Partition එකක් skewed කියලා ගණන් ගන්න median එක මෙන් කී ගුණයක් ලොකු වෙන්න ඕනද කියන එක. |
spark.sql.adaptive.skewJoin.skewedPartitionThresholdInBytes | 256MB | Partition එකක් split කරන්න කලින් ඒක අනිවාර්යයෙන්ම ඉක්මවන්න ඕන absolute size එක. |
spark.sql.adaptive.advisoryPartitionSizeInBytes | 64MB | Skewed partition එකක් කඩද්දි හැම slice එකකටම ඉලක්ක කරන size එක. |
Versions ගැන පොඩි සටහනක්: Spark 3.0 සහ 3.1 වල AQE ආවේ default disabled කරලා, ඉතින් spark.sql.adaptive.enabled=true ඔයාම set කරන්න ඕන වුණා. 3.2.0 ඉඳන් ඒක default on, skew join handling එකත් එහෙමයි. ඔයා පරණ runtime එකක ඉන්නවා නම්, ඒ පළවෙනි switch එක මුලින්ම check කරන්න. Feature එක "වැඩ කරන්නේ නෑ" කියලා අය හිතන්න බහුලවම හේතු වෙන්නේ ඒක.
ඒක explicitly on කරන්න ඕන නම්, මෙච්චරයි:
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.skewJoin.enabled", "true")
ඔයාගේ skew එක ගොඩක් දරුණු නම්, skewedPartitionFactor අඩු කරන එකෙන් (3 ට වගේ) හරි advisoryPartitionSizeInBytes අඩු කරන එකෙන් හරි Spark ට තව aggressive විදියට, පොඩි කෑලිවලට split කරන්න සලස්වන්න පුළුවන්. Tune කරන්න ඕන observe කරලා, අනුමානෙන් නෙවෙයි.
Enable කරාම ලැබෙන වාසි
ඔක්කොම එකට ගොනු කරලා බැලුවොත්, ඔයාට ඇත්තටම ලැබෙන්නේ මේවා:
Stragglers නැති කරනවා. ප්රධානම වාසිය මේක. එක ලොකු task එකක් ඉවර වෙනකම් මුළු stage එකම බලාගෙන ඉන්න එක නවතිනවා, skewed workloads වල wall-clock time එක ගොඩක් වෙලාවට කැපී පේන විදියට අඩු වෙනවා.
Out-of-memory failures වළක්වනවා. එක executor එකකට sort කරලා memory එකේ තියාගන්න වෙන 2 GB partition එකක් කියන්නේ disk එකට spill වෙන්න හරි කෙළින්ම crash වෙන්න හරි හොඳම අපේක්ෂකයා. ඒක split කරාම හැම task එකකම footprint එක පොඩියට, predictable විදියට තියෙනවා.
Cluster එක හරියට පාවිච්චි වෙනවා. අනිත් ඔක්කොම idle වෙලා එක core එකක් විතරක් වැඩ කරනවා වෙනුවට, වැඩේ cores ගොඩකට බෙදිලා යනවා. ඔයා සල්ලි ගෙවන්නේ මුළු cluster එකටම — මේකෙන් ඒක ඇත්තටම පාවිච්චි කරන්න පුළුවන් වෙනවා.
Code එකේ එක වෙනසක්වත් ඕන නෑ. Data engineers ලා වැඩියෙන්ම අගය කරන්නේ මේ කොටස. Salting නෑ, random-suffix සර්කස් නෑ, transformations අවුල් කරන merge-back logic නෑ. Config එකක් flip කරනවා, ඉතුරු ටික engine එක බලාගන්නවා.
Runtime එකේදී ඇත්ත තත්ත්වයට adapt වෙනවා. Skewed keys මොනවද කියලා ඔයා කලින් දැනගෙන ඉන්න ඕන නෑ. Skewed key එක දවසින් දවස වෙනස් වුණත් ඒක දිගටම වැඩ කරනවා — ප්රායෝගිකව ගොඩක් වෙලාවට වෙන්නෙත් ඒකමයි. Data එක ආපහු profile නොකර salting වලට ඒක කරන්න බෑ.
Manual hacks වර්ගයක්ම අනවශ්ය කරනවා. Spark 2.x කාලේ skew handle කරන්න කට කතාවෙන් පැවත ආපු උපක්රම ගොඩක් — salting, custom partitioners, jobs දෙකට කඩන එක — join skew වලට නම් දැන් සරලවම ඕන නෑ. Maintenance බර අතින් බැලුවොත් ඒක ලොකු සහනයක්.
සීමාවන් ගැන අවංකවම
කිසිම feature එකක් මැජික් නෙවෙයි. ඒකේ සීමා මොනවද කියලා කලින්ම දැනගෙන ඉන්න එක හොඳයි.
උදව් වෙන්නේ shuffle-based joins වලට විතරයි. Skew join handling apply වෙන්නේ sort-merge joins (සහ shuffle-hash joins) වලට. Broadcast join එකක shuffle එකක් නෑ, ඒ අර්ථයෙන් per-partition tasks කියලා දෙයකුත් නෑ, ඉතින් මේ optimisation එක ඒකට අදාළ වෙන්නේ නෑ. හැබැයි broadcast එක පොඩි table එක හැම තැනටම යවන නිසා, ඒකටම ආවේණික විදියට skew ප්රශ්නේ මගහරිනවා.
Map-output granularity එකට වඩා සිහින්ව split කරන්න බෑ. Spark skewed partition එකක් split කරන්නේ තනි තනි map tasks වල contributions group කරලා. එක map task එකක් දැනටමත් hot key එකට ලොකු chunk එකක් produce කරලා නම්, AQE ට ඒ chunk එකට වඩා පොඩියට කපන්න බෑ. Extreme cases වලදී result එක කොච්චර balanced වෙන්න පුළුවන්ද කියන එක මේකෙන් සීමා වෙනවා.
සමහර join types වලට සීමා තියෙනවා. Inner joins සම්පූර්ණයෙන්ම support කරනවා. Outer joins වලදී split කරන්න පුළුවන් safe side එක විතරයි (rows preserve කරන්නම ඕන පැත්ත නිදහසේ split කරන්න බෑ). ඒ නිසා join type එක අනුව optimisation එක එක පැත්තකට විතරක් apply වෙන්න හරි, කොහෙත්ම apply නොවෙන්න හරි පුළුවන්.
Aggregation skew හදන්නේ නෑ. මේ feature එක විශේෂයෙන්ම joins ගැන. ඔයාගේ skew එක තියෙන්නේ GROUP BY එකක නම් — කියමු, එක user කෙනෙක් අනිත් හැමෝම යටපත් කරන තැනක user_id එකකට events ගණන් කරනවා වගේ — ඒක වෙනම ප්රශ්නයක්. AQE එකේ partition coalescing එක යම් තරමකට උදව් වෙනවා, ඒත් බර aggregation skew එකකට තාමත් salting හරි two-step aggregation එකක් හරි ඕන වෙන්න පුළුවන්.
ඒක reactive, නොමිලේ ලැබෙන දෙයක් නෙවෙයි. Detection එක වෙන්නේ map stage එක ඉවර වුණාට පස්සේ, මොකද ඇත්ත statistics තියෙන්නේ එතකොට. පොඩි planning cost එකක් තියෙනවා, replication එකෙන් shuffle reads ටිකකුත් එකතු වෙනවා. මේක ඕන කරන workloads වලට ඒක rounding error එකක් විතරයි — ඒත් හරියටම බිංදුව නම් නෙවෙයි.
ඒක ඇත්තටම වැඩ කළාද කියලා බලාගන්නේ කොහොමද
ඒක විශ්වාසෙන්ම පිළිගන්න ඕන නෑ. Verify කරන්න ක්රම කිහිපයක් තියෙනවා:
Spark UI එකේ SQL/DataFrame tab එක. UI එකේ query එකේ plan එක open කරන්න. Shuffle-read node එක (AQEShuffleRead විදියට පේන්නේ) partitions කීයක් skewed කියලා සලකලා split කළාද කියලා report කරනවා. එතන skewed-partition count එක බිංදුවට වඩා වැඩි නම්, feature එක තමන්ගේ වැඩේ කරලා.
Physical plan එක. Adaptive query එකක් පේන්නේ AdaptiveSparkPlan විදියට. Execution එකට කලින් ඒක isFinalPlan=false කියලා mark වෙලා තියෙන්නේ; run වෙලා re-optimise වුණාට පස්සේ final plan එක isFinalPlan=true කියලා mark වෙනවා. එතකොට partitions ඇත්තටම handle කරපු විදිය ඔයාට ඒකෙන් කියවගන්න පුළුවන්.
Stage එකේ task count එක. Join stage එකේ ඔයා configure කරපු shuffle partitions ගාණට වඩා tasks වැඩියෙන් පේනවා නම්, ඒක පැහැදිලි ලකුණක්. ඒ අමතර tasks තමයි skewed partitions වලින් AQE හදපු slices.
Task duration distribution එක. Stage එකේ event timeline එකේ, හොඳින් ගිය run එකක tasks ඔක්කොම දළ වශයෙන් සමාන දිගකින් යුක්තයි. Skew handling off නම්, අනිත් ඔක්කොටම වඩා ගොඩක් දුරට ඇදිලා යන එක දිග bar එකක් ඔයාට පේනවා — ඒ තමයි straggler. On කරාම bars ඔක්කොම සමාන වෙනවා.
අවසාන වශයෙන්
Joins වල data skew කියන්නේ මුල්ම පාර මුහුණ දෙද්දි අද්භූත දෙයක් වගේ දැනෙන ප්රශ්නයක් — job එක කැඩිලා නෑ, හේතුවක් නැතුව හෙමින් යනවා විතරයි, ඒකත් සමහර වෙලාවට විතරයි. ඒත් යටින් බැලුවාම හේතුව බොහෝ වෙලාවට හරිම සරලයි: එක key එකක් අනිත් ඒවාට වඩා ගොඩක් ජනප්රියයි, ඒකේ rows ඔක්කොම එක partition එකකට ගොඩ වෙනවා, අවාසනාවන්ත task එකකට මුළු බරම උස්සන්න වෙනවා.
Spark එකේ adaptive skew join handling මේකට පහර දෙන්නේ හරියටම දෙන්න ඕන තැනින් — runtime එකේදී, ඇත්ත statistics පාවිච්චි කරලා. ප්රශ්නේ තියෙන partition එක handle කරන්න පුළුවන් කෑලිවලට split කරනවා, join එක නිවැරදිව තියාගන්න පොඩි පැත්ත replicate කරනවා. ප්රතිඵලය balanced parallelism, අඩු memory pressure, ඉක්මන් jobs — ඒ ඔක්කොම code rewrite එකකින් නෙවෙයි, configuration flag එකකින්.
ඔයා ඉන්නේ Spark 3.2 හරි ඊට පස්සේ version එකක හරි නම්, ඒක දැනටමත් on. ඔයාට කරන්න පුළුවන් වටිනාම දේ තමයි Spark UI එකේ skew අඳුරගන්න පුරුදු වෙන එක, feature එක ඇත්තටම ක්රියාත්මක වෙනවාද කියලා confirm කරගන්න එක, salting වගේ manual tricks ඉතුරු කරගන්න එක ඒකට ඇත්තටම අල්ලන්න බැරි cases වලට විතරක් — ඒ කියන්නේ වැඩි හරියක් aggregation skew. අනිත් හැම දේටම, වැඩේ engine එකට භාර දෙන්න.